NAMD
Popis
NAMD je softvér na simulácie molekulárnej dynamiky, ktorý využíva paralelný programovací model Charm++. Je známy svojou paralelnou efektívnosťou a často sa používa na simulácie veľkých systémov s miliónmi atómov. Vyvinula ho kolaborácia Theoretical and Computational Biophysics Group (TCB) a Parallel Programming Laboratory (PPL) na University of Illinois at Urbana–Champaign.
Oficiálna dokumentácia
Dokumentáciu softvéru nájdete na oficiálnej webovej stránke NAMD a používateľskú príručku pre verziu 2.14 v oficiálnej používateľskej príručke NAMD 2.14.
Dostupné verzie
V súčasnosti je dostupná nasledujúca verzia NAMD:
- Závislosti pri behu:
- Žiadne – potrebné knižnice a závislosti sa načítajú automaticky spolu s modulom \(NAMD/2.14-foss-2021a-CUDA-11.3.1\).
Modul NAMD môžete načítať pomocou nasledujúceho príkazu:
module load NAMD/2.14-foss-2021a-CUDA-11.3.1
NAMD Benchmark
Aby sme lepšie pochopili, ako NAMD využíva dostupný hardvér na Devane a ako dosiahnuť dobrý výkon, môžeme preskúmať vplyv počtu MPI rankov na uzol a počtu OpenMP vlákien na výkon benchmarku.
Na spustenie benchmarkov sa použil nasledujúci príkaz:
mpiexec -np $ntmpi charmrun +p $ntomp +isomalloc_sync +setcpuaffinity namd2 +devices $gpu $trajectory
kde ntmpi a ntomp predstavujú počet MPI rankov a OpenMP vlákien a gpu predstavuje ID použitých grafických procesorov (0, 1, 2, 3).
Viac informácií o týchto benchmarkových systémoch a vstupné súbory na stiahnutie nájdete tu.
Info
Jednouzlové benchmarky boli spustené na lokálnom NVMe disku /work/, ktorý je integrovaný do každého výpočtového uzla a je zvyčajne rýchlejší než zdieľané súborové systémy /home/ a /scratch/.
Benchmarky boli vykonané na nasledujúcom systéme:
Ako vstupný súbor pre tento benchmark sa použil nasledujúci súbor:
Vstupný súbor NAMD
#############################################################
## ADJUSTABLE PARAMETERS                                   ##
#############################################################
structure          stmv.psf
coordinates        stmv.pdb


#############################################################
## SIMULATION PARAMETERS                                   ##
#############################################################

# Input
paraTypeCharmm      on
parameters          par_all27_prot_na.inp
temperature         298


# Force-Field Parameters
exclude             scaled1-4
1-4scaling          1.0
cutoff              12.
switching           on
switchdist          10.
pairlistdist        13.5


# Integrator Parameters
timestep            1.0
nonbondedFreq       1
fullElectFrequency  4
stepspercycle       20


# Constant Temperature Control
langevin            on    ;# do langevin dynamics
langevinDamping     5     ;# damping coefficient (gamma) of 5/ps
langevinTemp        298
langevinHydrogen    off   ;# don't couple langevin bath to hydrogens


# Constant Pressure Control (variable volume)
useGroupPressure      yes  ;# needed for rigidBonds
useFlexibleCell       no
useConstantArea       no

langevinPiston        on
langevinPistonTarget  1.01325 ;# in bar -> 1 atm
langevinPistonPeriod  100.
langevinPistonDecay   50.
langevinPistonTemp    298

cellBasisVector1     216.832    0.   0.
cellBasisVector2     0.   216.832    0.
cellBasisVector3     0.    0   216.832
cellOrigin           0.    0.   0.

PME                  on
PMEGridSizeX         216
PMEGridSizeY         216
PMEGridSizeZ         216

# Output
outputName          /work/$SLURM_JOB_ID/stmv-output

outputEnergies      20
outputTiming        20

numsteps            50000
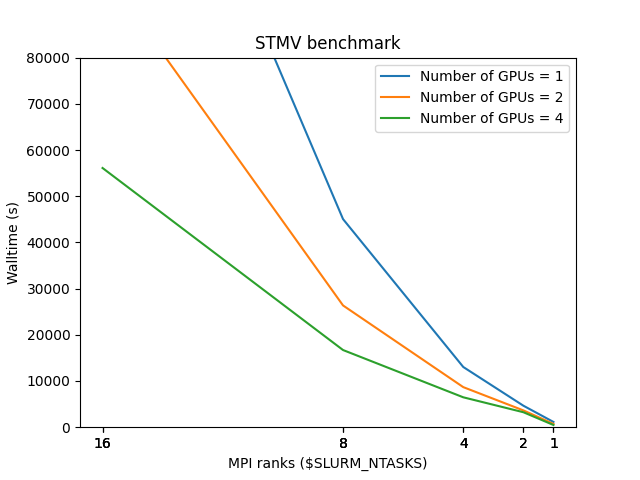
Číselné hodnoty benchmarku (ns/deň) sú nasledovné:
| GPU/MPI | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|
| 1 | 1136 | 4652 | 13031 | 45043 | |
| 2 | 712 | 3635 | 8673 | 26355 | 99093 |
| 4 | 477 | 3241 | 6471 | 16703 | 56104 |
Info
Zostávajúce kombinácie MPI/OMP nebolo možné uskutočniť z dôvodu obmedzenia pamäte GPU.
Používateľom sa preto odporúča vybrať kombináciu MPI/GPU, ktorá zodpovedá veľkosti ich systému. Vyššie uvedená tabuľka ukazuje najvyššiu absolútnu priepustnosť pri použití 2 GPU a 16 MPI rankov, zatiaľ čo pre malé systémy je z hľadiska BU najvýhodnejší jeden MPI rank.
Je dôležité uvedomiť si, že ak používateľ požiada o jeden MPI rank
(#SBATCH --ntasks-per-node=1) a napríklad 32 CPU
(#SBATCH --cpus-per-task=32), bude mu účtovaných 32 BU. Pri požiadavke na
2 GPU (#SBATCH --gres=gpu:2) je preto potrebné túto skutočnosť zohľadniť,
keďže na akcelerovaných uzloch sa odporúča alokovať 16 CPU na jednu GPU.
Vo všeobecnosti sú z hľadiska BU najvýhodnejšie nasledujúce kombinácie požadovaných zdrojov:
| #SBATCH --ntasks-per-node= | #SBATCH --cpus-per-task= | #SBATCH --gres=gpu= |
|---|---|---|
| 1 | 16 | 1 |
| 2 | 32 | 2 |
| 3 | 16 | 3 |
| 4 | 16 | 4 |
Príklad spúšťacieho skriptu
Tento skript si môžete skopírovať, upraviť podľa svojich potrieb ako
namd_run.sh a úlohu odoslať na výpočtový uzol pomocou príkazu
sbatch namd_run.sh.
#!/bin/bash
#SBATCH -J "namd_job"                  # name of job in SLURM
#SBATCH --account=<project>            # project number
#SBATCH --partition=gpu                # GPU partition (NAMD is GPU-aware only)
#SBATCH --nodes=1                      # GPU allocation allows only a single node
#SBATCH --ntasks-per-node=             # number of MPI ranks per node
#SBATCH --cpus-per-task=               # number of CPUs per MPI rank
#SBATCH --time=hh:mm:ss                # time limit for a job
#SBATCH -o stdout.%J.out               # standard output
#SBATCH -e stderr.%J.out               # error output


module load NAMD/2.14-foss-2021a-CUDA-11.3.1

# Modify according to specific needs
init_dir=`pwd`
work_dir=/work/$SLURM_JOB_ID

# Copy files over
input_files=""
output_files=""

# Move to working directory
mkdir -p $work_dir
cd $work_dir
cp $input_files $work_dir/.

# Start NAMD
mpiexec -np ${SLURM_NTASKS} charmrun +p ${SLURM_CPUS_PER_TASK} \
    +isomalloc_sync +setcpuaffinity namd2 +devices 0 <input_file> \
    # adjust to the requested GPUs, e.g. +devices 0,1

# Move files back
cp $output_files $init_dir/.
GPU partícia
NAMD je kompilovaný iba ako GPU-aware verzia a musí sa spúšťať v partícii gpu.
ID GPU
Premenná DEVICES v nasledujúcom skripte sa vzťahuje na ID GPU, ktoré sa
pohybujú od 0 do 3. Dôrazne odporúčame zapisovať ID GPU v príkaze priamo
ako text, a nie prostredníctvom shellovej premennej. Ak má byť výpočet
spustený na 1 GPU, príslušná časť príkazu by mala vyzerať ako
+devices 0, pre 2 GPU použite +devices 0,1, atď.