ORCA
Popis
ORCA je balík programov na ab initio kvantovú chémiu, ktorý obsahuje moderné metódy elektronovej štruktúry vrátane teórie hustotového funkcionálu, mnohotelovej poruchovej teórie, coupled-cluster metód, multireferenčných metód a semiempirických metód kvantovej chémie. Jeho hlavnou oblasťou použitia sú väčšie molekuly, komplexy prechodných kovov a ich spektroskopické vlastnosti. ORCA je vyvíjaná výskumnou skupinou Franka Neeseho. Bezplatná verzia je dostupná iba na akademické použitie na akademických inštitúciách.
Oficiálna dokumentácia
Dokumentáciu softvéru a používateľskú príručku nájdete tu. Na stiahnutie príručky vo formáte .pdf je potrebné zaregistrovať sa na komunitnom fóre.
Dostupné verzie
V súčasnosti sú dostupné nasledujúce verzie ORCA:
- Závislosti pri behu:
- Žiadne – potrebné knižnice a závislosti sa načítajú automaticky spolu s modulom \(ORCA/5.0.4-OpenMPI-4.1.4\).
Modul ORCA môžete načítať pomocou nasledujúceho príkazu:
module load ORCA/5.0.4-OpenMPI-4.1.4
- Závislosti pri behu:
- Žiadne – potrebné knižnice a závislosti sa načítajú automaticky spolu s modulom \(ORCA/6.0.0-OpenMPI-4.1.6\).
Modul ORCA môžete načítať pomocou nasledujúceho príkazu:
module load ORCA/6.0.0-OpenMPI-4.1.6
- Závislosti pri behu:
- Žiadne – potrebné knižnice a závislosti sa načítajú automaticky spolu s modulom \(ORCA/6.0.1-OpenMPI-4.1.6\).
Modul ORCA môžete načítať pomocou nasledujúceho príkazu:
module load ORCA/6.0.1-OpenMPI-4.1.6
ORCA Benchmark
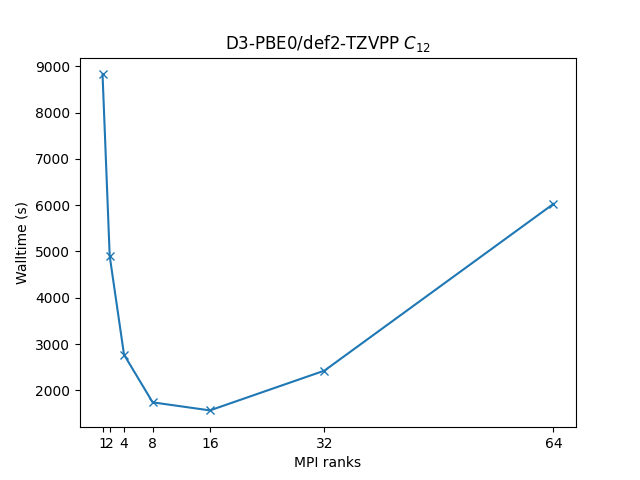
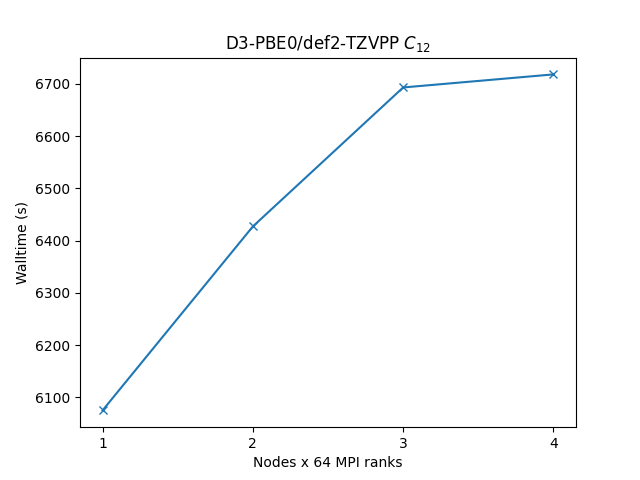
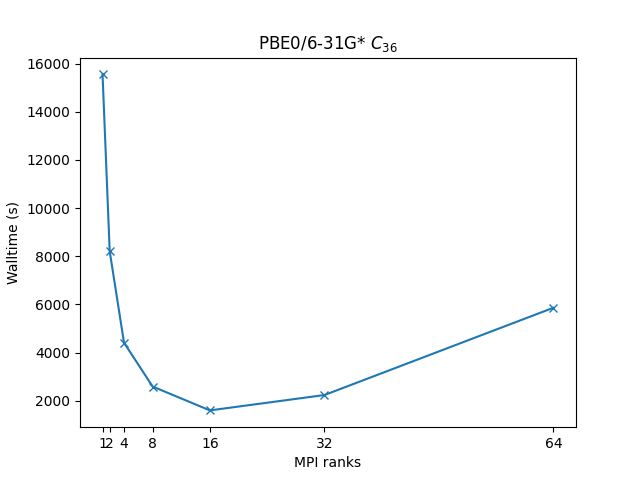
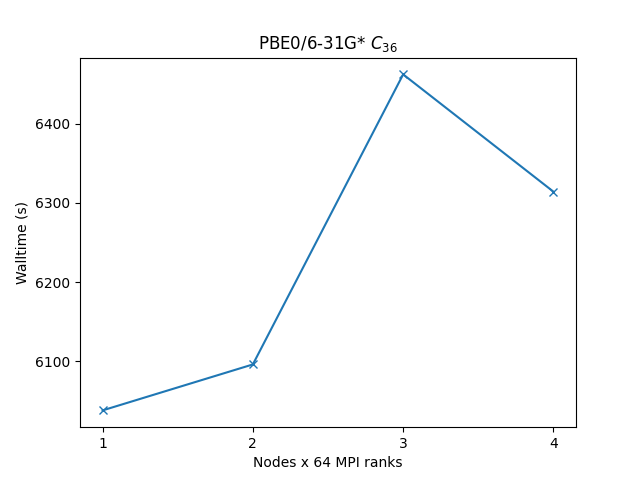
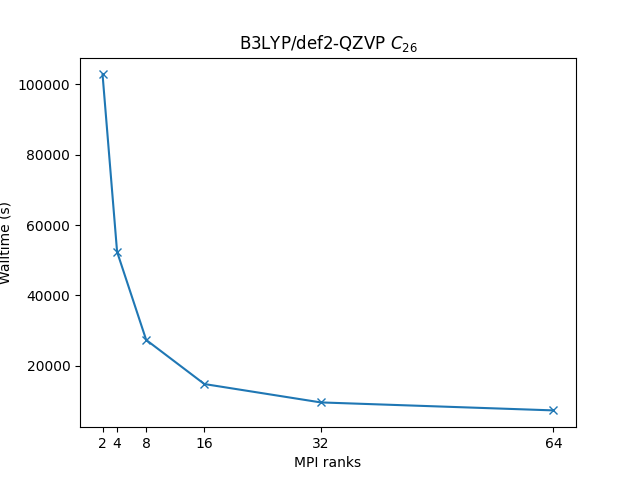
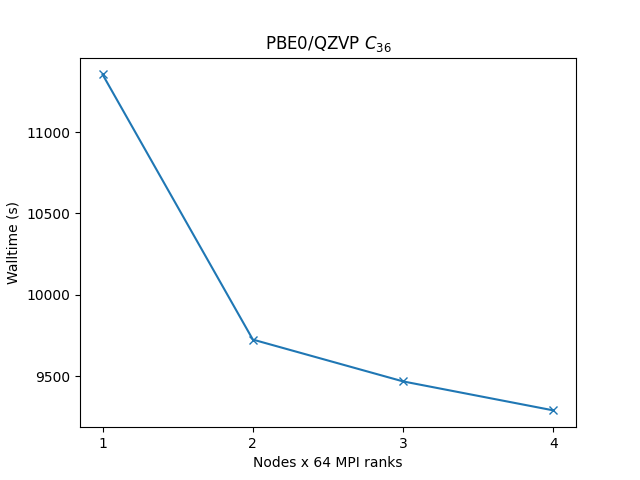
Aby sme lepšie pochopili, ako ORCA využíva dostupný hardvér na Devane a ako dosiahnuť dobrý výkon, môžeme preskúmať vplyv počtu MPI rankov na uzol na výkon benchmarku.
Na spustenie benchmarkov sa použil nasledujúci príkaz:
/storage-apps/easybuild/software/ORCA/5.0.4-OpenMPI-4.1.4/orca \
    ${benchmark}.inp > ${benchmark}.out
Info
Jednouzlové benchmarky boli spustené na lokálnom NVMe disku /work/, ktorý je integrovaný do každého výpočtového uzla a je zvyčajne rýchlejší než zdieľané súborové systémy /home/ a /scratch/.
Benchmarky boli vykonané na nasledujúcich systémoch:
Geometrická optimalizácia C12 diméru benzénu na úrovni teórie D3-PBE0/def2-TZVPP, ktorá ilustruje najčasovo náročnejšiu časť výpočtu, t. j. SCF výpočty.
c12-pbe0-d30-tzvpp.inp
! D3ZERO PBE0 def2-TZVPP Opt
%pal
nprocs n
end

*xyz 0 1
C    -0.062619375461      0.000000000000     -2.001649629456
C    -1.218688068356     -0.354690359108     -1.303485629456
C     1.093449317434      0.354690359108     -1.303485629456
H    -2.118113174883     -0.630640582469     -1.846658629456
H     1.992874423961      0.630640582469     -1.846658629456
C    -1.218688068356     -0.354690359108      0.092844370544
C     1.093449317434      0.354690359108      0.092844370544
H    -2.118113174883     -0.630640582469      0.636017370544
H     1.992874423961      0.630640582469      0.636017370544
C    -0.062619375461      0.000000000000      0.791008370544
H    -0.062619375461      0.000000000000      1.877355370544
H    -0.062619375461      0.000000000000     -3.087996629456
C    -0.264430744069     -3.762741758810     -2.205619137167
C    -1.420499436964     -4.117432117918     -1.507455137167
C     0.891637948826     -3.408051399702     -1.507455137167
H    -2.319924543491     -4.393382341279     -2.050628137167
H     1.791063055353     -3.132101176340     -2.050628137167
C    -1.420499436964     -4.117432117918     -0.111125137167
C     0.891637948826     -3.408051399702     -0.111125137167
H    -2.319924543491     -4.393382341279      0.432047862833
H     1.791063055353     -3.132101176340      0.432047862833
C    -0.264430744069     -3.762741758810      0.587038862833
H    -0.264430744069     -3.762741758810      1.673385862833
H    -0.264430744069     -3.762741758810     -3.291966137167
*
| Výkon na jednom uzle | Výkon na viacerých uzloch |
|---|---|
 |
 |
Geometrická optimalizácia C36 fullerénu na úrovni teórie PBE0/6-31G*, ktorá ilustruje najčasovo náročnejšiu časť výpočtu, t. j. SCF výpočty.
c36-pbe0-631gs.inp
! PBE0 6-31G* Opt
%pal
nprocs n
end
# B3LYP is here the method (DFT functional), def2-SVP the basis set and Opt is the jobtype (geometry optimization).
# Order of the keywords is not important.

*xyz 0 1
 C    -1.52700   1.76820   1.10880
 C    -2.36070   0.72480   1.26750
 C    -1.67820  -2.27640   0.13880
 C    -2.49780  -1.40820   0.80110
 C    -1.83200  -0.49960   1.65300
 C    -0.21160   1.77830   1.49380
 C     1.81570   0.46710   1.62050
 C     0.41900   0.58540   1.96880
 C    -0.43190  -0.62020   1.97940
 C     0.19450  -1.81880   1.50120
 C    -0.43300  -2.60020   0.52680
 C     1.65110   2.23630   0.12250
 C     0.41060   2.54900   0.51060
 C     2.48860   1.37490   0.76110
 C     2.35930  -0.75560   1.27290
 C     1.51570  -1.79100   1.12690
 C    -3.17430  -0.63550  -0.13640
 C    -1.52890  -1.78030  -1.13340
 C    -2.35450  -0.73210  -1.24830
 C    -3.18670   0.66160   0.15930
 C    -2.52400   1.42430  -0.78300
 C    -0.45510   2.61090  -0.56090
 C    -1.70130   2.31610  -0.15420
 C     0.44340  -2.60890  -0.54250
 C    -0.20120  -1.80680  -1.49020
 C     0.42820  -0.58870  -1.92240
 C    -0.42340   0.62590  -1.94160
 C    -1.82920   0.50110  -1.60990
 C     0.22010   1.84690  -1.52860
 C     1.69120  -2.30340  -0.14430
 C     2.51320  -1.39870  -0.74120
 C     1.83550  -0.46390  -1.58540
 C     3.20040  -0.63110   0.17580
 C     3.20210   0.65420  -0.17840
 C     2.40480   0.77950  -1.29880
 C     1.55490   1.81710  -1.18780
*
| Výkon na jednom uzle | Výkon na viacerých uzloch |
|---|---|
 |
 |
Geometrická optimalizácia C36 fullerénu na úrovni teórie PBE0/def2-QZVP*, ktorá ilustruje najčasovo náročnejšiu časť výpočtu, t. j. SCF výpočty.
c36-qzvp.inp
! B3LYP def2-QZVP Opt
%pal
nprocs n
end
# B3LYP is here the method (DFT functional), def2-SVP the basis set and Opt is the jobtype (geometry optimization).
# Order of the keywords is not important.

*xyz 0 1
 C    -1.52700   1.76820   1.10880
 C    -2.36070   0.72480   1.26750
 C    -1.67820  -2.27640   0.13880
 C    -2.49780  -1.40820   0.80110
 C    -1.83200  -0.49960   1.65300
 C    -0.21160   1.77830   1.49380
 C     1.81570   0.46710   1.62050
 C     0.41900   0.58540   1.96880
 C    -0.43190  -0.62020   1.97940
 C     0.19450  -1.81880   1.50120
 C    -0.43300  -2.60020   0.52680
 C     1.65110   2.23630   0.12250
 C     0.41060   2.54900   0.51060
 C     2.48860   1.37490   0.76110
 C     2.35930  -0.75560   1.27290
 C     1.51570  -1.79100   1.12690
 C    -3.17430  -0.63550  -0.13640
 C    -1.52890  -1.78030  -1.13340
 C    -2.35450  -0.73210  -1.24830
 C    -3.18670   0.66160   0.15930
 C    -2.52400   1.42430  -0.78300
 C    -0.45510   2.61090  -0.56090
 C    -1.70130   2.31610  -0.15420
 C     0.44340  -2.60890  -0.54250
 C    -0.20120  -1.80680  -1.49020
 C     0.42820  -0.58870  -1.92240
 C    -0.42340   0.62590  -1.94160
 C    -1.82920   0.50110  -1.60990
 C     0.22010   1.84690  -1.52860
 C     1.69120  -2.30340  -0.14430
 C     2.51320  -1.39870  -0.74120
 C     1.83550  -0.46390  -1.58540
 C     3.20040  -0.63110   0.17580
 C     3.20210   0.65420  -0.17840
 C     2.40480   0.77950  -1.29880
 C     1.55490   1.81710  -1.18780
*
| Výkon na jednom uzle | Výkon na viacerých uzloch |
|---|---|
 |
 |
Príklad spúšťacieho skriptu
Použité súborové systémy
Na dosiahnutie najlepšieho výkonu používajte pri výpočtoch na jednom uzle lokálny NVMe disk /work/. Pri výpočtoch na viacerých uzloch používajte zdieľaný súborový systém (napr. /scratch/) alebo replikujte vstupné súbory do /work/ na každom uzle.
MPI ranky
V prípade paralelného výpočtu použite vo vstupnom súbore voľbu nprocs v bloku %pal namiesto direktívy %palN.
%pal
nprocs ${MPI ranks}
end
Tento skript si môžete skopírovať a upraviť ako orca_run.sh a úlohu odoslať na výpočtový uzol pomocou príkazu \(sbatch orca_run.sh\).
#!/bin/bash
#SBATCH -J "orca_job"           # name of job in SLURM
#SBATCH --account=<project>     # project number
#SBATCH --partition=            # selected partition (short, medium, long)
#SBATCH --ntasks=               # number of MPI ranks (parallel run)
#SBATCH --time=hh:mm:ss          # time limit for a job
#SBATCH -o stdout.%J.out        # standard output
#SBATCH -e stderr.%J.out        # error output

# module load ORCA/5.0.4-OpenMPI-4.1.4 # For ORCA 5.0.4 (no longer available)
module load ORCA/6.0.0-OpenMPI-4.1.6 # For ORCA 6.0.0

INIT_DIR=`pwd`
SCRATCH=/work/$SLURM_JOB_ID

mkdir $SCRATCH

INPUT=orca_input.inp
OUTPUT=orca_output.out

cp $INPUT $SCRATCH/$INPUT

cd $SCRATCH

# If you wish to run ORCA in parallel, you should use complete path to the binary.
# /storage-apps/easybuild/software/ORCA/5.0.4-OpenMPI-4.1.4/orca $INPUT > $INIT_DIR/$OUTPUT # For ORCA 5.0.4
mpiexec -np $SLURM_NTASKS \
    /storage-apps/software/orca/orca_6_0_0_shared_openmpi416_avx2/orca \
    $INPUT > $INIT_DIR/$OUTPUT # For ORCA 6.0.0